公众号旧文
如何一键获取你在公众号发表过的文章数据?
读者们可能已经发现了,我在新文章的底部加入了一个新的板块:
你还可能感兴趣的文章:

文章标题1
文章标题2
文章标题3
文章标题4
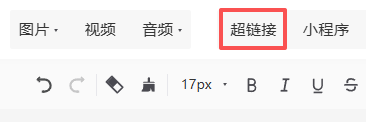
看上去没什么难的,公众号本来就自带插入超链接的功能:
但写了几篇以后,就发现有问题了:
1、手动插入,效率低,而且,会不记得自己曾经写过的文章标题
2、就算记得标题,也不记得阅读量,不知道该放哪一篇进来
于是每次写新文章,都要打开发表记录,从后往前逐页翻,但随着新文章的发表,已经放过的文章,所在页的页码会顺延,比如我想把第100篇文章放进来,放进来的时候它是第100篇,在发表记录的第10页,但是再发表一篇文章,第100篇就变成了第101篇,就会顺延到发表记录的第11页。
作为一个懒汉,自然不肯一直这样麻烦,于是就主动探索了一键获取文章列表的方法,争取一次性拿到所有的文章标题和阅读量,这样后续就不用再翻发表记录了,可以方便的手动插入文章的超链接,甚至还可以写代码随机生成每天要插入的四篇文章列表。
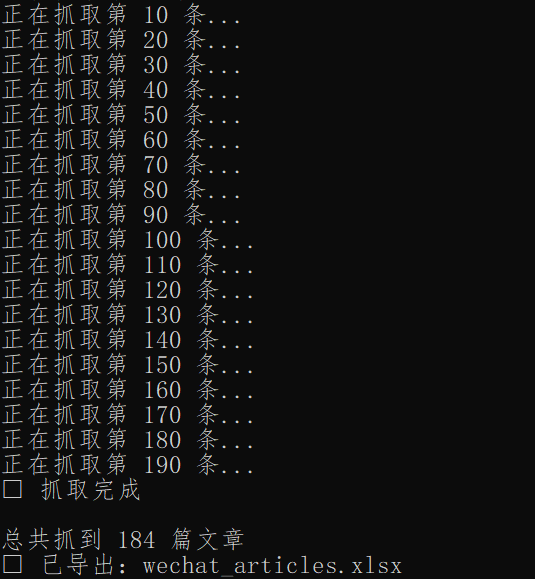
下面分享使用的抓取脚本:
import requests
import re
import json
import html
from openpyxl import Workbook
# =========================
# 🔑 填你的 Cookie 和 UA
# =========================
HEADERS = {
    "cookie": "YOUR_COOKIE",
    "user-agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/146.0.0.0 Safari/537.36"
}
TOKEN = "YOUR_TOKEN"  # 改成你自己的
# =========================
# 🚀 开始抓取
# =========================
all_articles = []
for begin in range(0, 500, 10):  # 可改大一点
    print(f"正在抓取第 {begin} 条...")
    url = f"https://mp.weixin.qq.com/cgi-bin/appmsgpublish?sub=list&begin={begin}&count=10&token={TOKEN}&lang=zh_CN"
    res = requests.get(url, headers=HEADERS)
    text = res.text
    # 提取 JSON
    match = re.search(r'publish_page\s*=\s*(\{.*?\});', text, re.S)
    if not match:
        print("❌ 解析失败,可能 cookie 过期")
        break
    data = json.loads(match.group(1))
    publish_list = data.get("publish_list", [])
    if not publish_list:
        print("✅ 抓取完成")
        break
    for item in publish_list:
        raw = item["publish_info"]
        # 反转义
        decoded = html.unescape(raw)
        # 再解析
        info = json.loads(decoded)
        for msg in info["appmsg_info"]:
            all_articles.append({
                "title": msg["title"],
                "url": msg["content_url"],
                "read": msg.get("read_num", 0)
            })
print(f"\n总共抓到 {len(all_articles)} 篇文章")
# =========================
# 📊 导出 Excel
# =========================
wb = Workbook()
ws = wb.active
ws.title = "公众号文章"
# 表头
ws.append(["标题", "阅读量", "链接"])
# 数据
for a in all_articles:
    ws.append([a["title"], a["read"], a["url"]])
wb.save("wechat_articles.xlsx")
print("✅ 已导出:wechat_articles.xlsx")
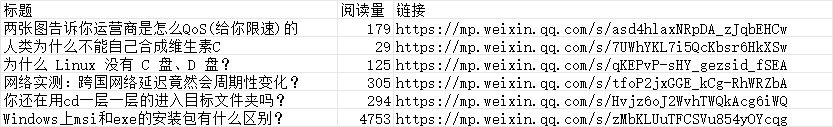
Excel 打开后,效果如下图所示:
人生苦短,我用Python,懒汉才是社会发展的动力(逃。