公众号旧文
网上冲浪三十年,我遇到的最复杂的验证码
今天想进一个群,但是要求验证,题目如下:
你有 3600 秒完成验证。答错需 3600 秒后重试。 在最新版 Chrome 中,发送的 ALPS 扩展是从哪个 commit 开始的?
取该 commit hash 的后 8 位。 提供一个 UUIDv4:
[commit后8位]-xxxx-4xxx-yxxx-xxxx14c1746b要求这个 UUID 的字节 SHA-512 的前 33 个 bit 全为 0。 完成后发送:/answer 你的UUID
第一眼看,这题像是一个普通的技术问答:
找到 Chrome 某个功能对应的 commit,再取 commit hash 的后 8 位。
但真正的难点并不在这里。
当拿到 commit hash 之后,后面变成了一道典型的 PoW 验证题。
所谓 PoW,就是 Proof of Work,工作量证明。
它不是让你直接答出结果,而是让你的电脑做一段计算工作,找到一个满足特定条件的字符串。
这个过程没有捷径,核心就是不断尝试,直到撞上符合条件的结果。
翻了几分钟的 commit 历史,我拿到了 commit hash:
cfb168170153be6ddba2a695f72409f9793870b2取最后 8 位,得到:
793870b2所以题目要求的 UUID 格式就变成了:
793870b2-xxxx-4xxx-yxxx-xxxx14c1746b这里有几部分是固定的。
第一段必须是 commit hash 的后 8 位:
793870b2最后 8 位也固定:
14c1746b中间的 4xxx 表示这个 UUID 必须符合 UUIDv4 的格式。
而 yxxx 中的 y 也不是随便填的。
按照 UUID variant 规则,这一位通常只能是:
8、9、a、b也就是说,它的二进制高位必须符合 UUID 的标准格式。
所以,这不是随便拼一个字符串,而是要生成一个合法的 UUIDv4。
接下来是最关键的要求:
使其字节 sha512 的前 33 个 bit 全为 0SHA-512 是一种哈希算法。
无论输入是什么,它都会输出一个 512 bit 的哈希结果,也就是 64 个字节。
题目要求“前 33 个 bit 全为 0”,换成字节理解,就是:
第 1 个字节 = 0
第 2 个字节 = 0
第 3 个字节 = 0
第 4 个字节 = 0
第 5 个字节的最高 1 bit = 0
也就是哈希结果开头必须长这样:
00000000 00000000 00000000 00000000 0...这件事看起来简单,但概率非常低。
因为 SHA-512 的输出可以近似看成随机分布。 前 1 个 bit 是 0 的概率是:
1 / 2前 2 个 bit 都是 0 的概率是:
1 / 4前 33 个 bit 全是 0 的概率就是:
1 / 2^33也就是大约:
1 / 8,589,934,592平均要尝试 85.9 亿次,才可能找到一个满足条件的 UUID。
这就是 PoW 的本质:不是靠猜,而是靠算。
为什么不能反推呢?
因为 SHA-512 是密码学哈希函数。
它的设计目标之一就是不可逆。
也就是说,给你一个目标哈希条件,你不能直接倒推出哪个 UUID 能满足它。
唯一现实的办法就是:
生成一个 UUID
计算它的 SHA-512
检查前 33 bit 是否全为 0
不满足就换下一个
直到找到为止
这个过程就是暴力搜索。
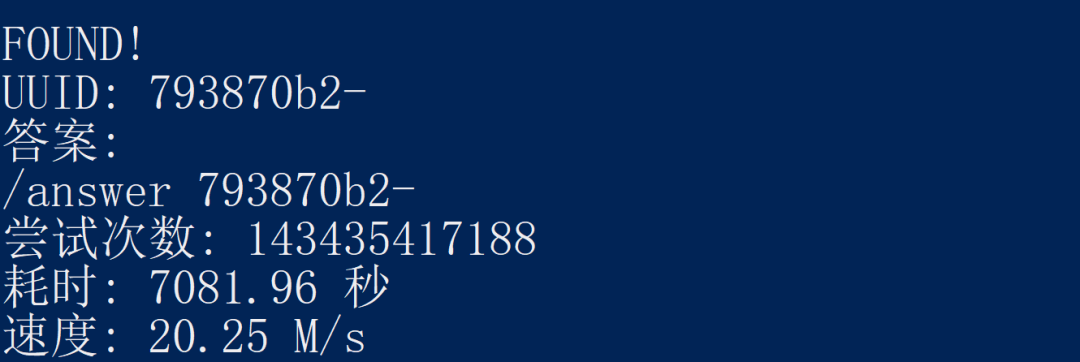
在我的电脑上跑 Go 程序时,输出是这样的:
commit 后 8 位: 793870b2
UUID 格式: 793870b2-xxxx-4xxx-yxxx-xxxx14c1746b
hashMode: raw
CPU workers: 32
开始搜索...
已尝试 100771369,速度 33.52 M/s,运行 3 秒
这里的速度是:
33.52 M/s也就是每秒大约尝试 3352 万个 UUID。
理论平均尝试次数是:
2^33 = 8,589,934,592所以平均耗时大约是:
8,589,934,592 / 33,520,000 ≈ 256 秒也就是 4 分多钟。
但实际情况完全看运气。
可能几十秒就出,也可能十几分钟才出。
这就是概率问题。
最终我的耗时是7000秒,也就是2小时。
这个题里面还有一点:
到底是对 UUID 的“字符串”算 SHA-512,还是对 UUID 的“原始字节”算 SHA-512?
比如这个 UUID:
793870b2-abcd-4abc-8abc-abcd14c1746b如果按字符串算,就是对这串带横杠的文本算哈希:
"793870b2-abcd-4abc-8abc-abcd14c1746b"但如果按字节算,就是把 UUID 转成 16 个原始字节,然后对这 16 个字节算哈希。
题目里写的是:
字节 sha512所以更合理的理解是:对 UUID 的 16 个原始字节计算 SHA-512。
这也是程序默认使用 raw 模式的原因。
整个验证过程可以拆成四步:
第一步,找到 Chrome ALPS 扩展对应的 commit hash。
第二步,取 commit hash 后 8 位,作为 UUID 第一段。
第三步,按照 UUIDv4 规则生成候选 UUID,保证格式为:
793870b2-xxxx-4xxx-yxxx-xxxx14c1746b第四步,不断计算候选 UUID 的 SHA-512,直到找到前 33 个 bit 全为 0 的结果。
找到之后,程序会输出:
/answer 793870b2-xxxx-4xxx-yxxx-xxxx14c1746b把这一整行发出去即可。
这类验证码把“回答问题”变成了“付出计算成本”。
普通验证码是让人识别图片、点选内容,目的是区分人和机器。
而 PoW 验证不是为了区分人和机器,而是为了限制滥用。
因为每提交一次答案,都需要真实消耗 CPU 时间。
对普通用户来说,跑几分钟可以接受。
但对批量脚本、机器人、垃圾注册来说,如果每次都要付出计算成本,攻击成本就会被明显抬高。
这也是很多技术社区、群组、反滥用系统喜欢使用 PoW 验证的原因。
这道题表面上问的是 Chrome commit,实际上考的是完整的技术链路:
commit hash
UUIDv4 格式
二进制字节
SHA-512
前导零 bit
暴力搜索
概率期望
并发计算
PoW 验证
它不像选择题那样靠蒙。
你可以蒙 commit,也可以蒙 UUID,但要蒙中 SHA-512 前 33 bit 全 0,概率只有几十亿分之一。
所以真正靠谱的做法只有让电脑跑起来。
这就是 PoW 验证最有意思的地方:答案不是想出来的,是算出来的。
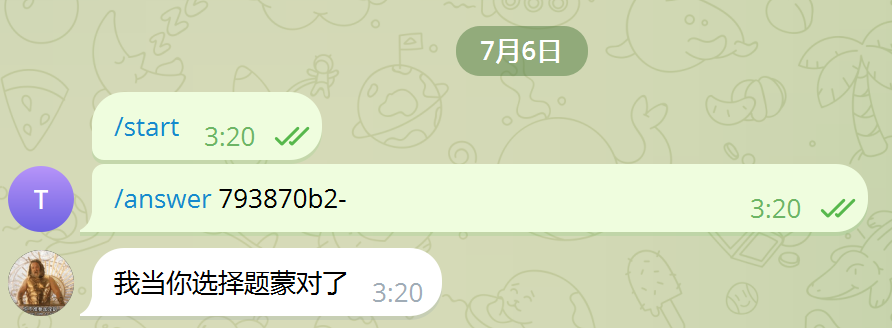
最终,在折腾了大概3小时后,我进去了!