公众号旧文
有些链接明明是在浏览器里点击的,为什么电脑却打开了本地软件?
比如百度网盘,点击网页右上角的:
浏览器就会弹窗提示,是否要打开百度网盘客户端。
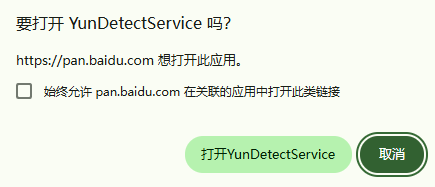
但浏览器并没有启动软件的权限。
那这是怎么做到的?
一、浏览器首先会判断:这是什么协议?
当你打开一个网址时:
https://openai.com浏览器会先解析最前面的部分:
https://这叫协议。
因为 https 是浏览器原生支持的协议,所以浏览器会自己处理:
- 建立 HTTPS 连接
- 联网获取网页
- 渲染 HTML
- 显示页面
整个过程都由浏览器完成。
但如果浏览器看到的是:
steam://run/730情况就不一样了。
浏览器会发现不认识 steam 这个协议。
于是它不会自己处理,而是把这个请求交给操作系统。
二、操作系统里有协议关联机制
Windows、macOS、Linux 都有类似机制。
系统会记录某个协议应该由哪个程序处理。
例如:
| 协议 | 对应程序 |
|---|---|
http:// |
浏览器 |
mailto: |
邮件客户端 |
tg:// |
Telegram |
steam:// |
Steam |
vscode:// |
VS Code |
这有点像文件关联。
比如:
.mp4用什么播放器打开.txt用什么编辑器打开
但这里关联的不是文件,而是协议。
三、浏览器真正做的事:问操作系统
例如用户点击:
tg://resolve?domain=durov浏览器发现 tg:// 不是自己支持的协议,于是:
- 调用系统接口
- 询问操作系统:谁负责处理 tg:// ?
系统会回答:Telegram
随后,系统启动 Telegram,并把完整 URL 一起传过去。
四、软件收到 URL 后,会自己解析
Telegram 启动后,会解析:
resolve?domain=durov于是就知道:
- 要打开哪个频道
- 进入哪个聊天
- 跳转哪个群组
这类机制有个名字:深链接(Deep Link)
现代 APP 非常依赖它。
例如:
weixin://alipays://spotify://- `discord://`````
网页、二维码、其它 APP,都可以通过深链接直接拉起目标应用,手机生态尤其依赖这个机制。
五、为什么浏览器会弹确认框?
因为网页虽然不能直接控制电脑,但它能请求系统启动本地程序。
如果没有限制,恶意网站就可能疯狂拉起各种软件。
因此现代浏览器会增加确认步骤,避免网页滥用协议调用。
六、手机上的更多例子
例如:
taobao://weixin://- `bilibili://`````
当你扫码或点击链接时:
- 浏览器识别协议
- Android/iOS 查询关联
- 系统拉起对应 APP
- APP 跳转到指定页面
这就是现代移动生态里最核心的机制之一:APP 间跳转。
很多打开 APP 领取优惠券、跳转支付页面、打开直播间,都依赖深链接。
七、URL 的意义已经变了
互联网刚出现时,URL 原本只是定位网络资源
比如:
https://example.com/file.zip但后来,它逐渐演化成了整个操作系统的资源入口。
如今 URL 不仅能:
- 打开网页
- 启动本地软件
- 拉起 APP
- 打开游戏
- 跳转系统功能
甚至 Windows 还有:
ms-settings:可以直接打开系统设置页面。
也就是说 URL 早就不只是网址了。
它已经变成了操作系统里的统一资源定位入口。