公众号旧文
为什么 Linux 文件夹的大小总是 4096?
在使用 Linux 时,相信你和我一样,都注意到了一个现象:
无论文件夹里有没有文件,执行 ls -l 时看到的大小几乎总是 4096。
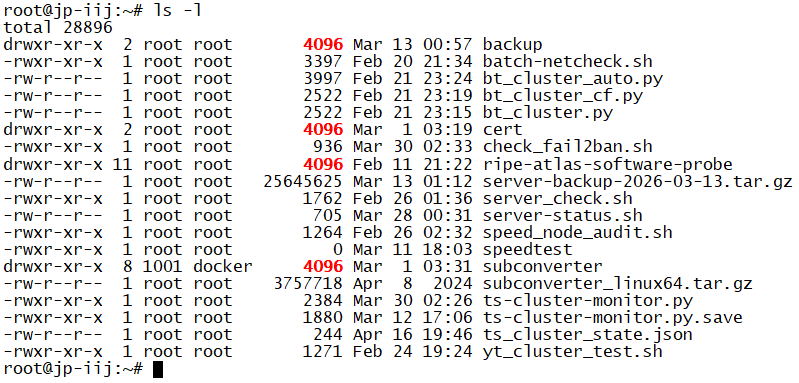
在上一篇文章一张图片看懂 Linux 权限中,
我们知道了,第一列的字母 d,意味着这是一个文件夹。
而上图中这 4 行以字母 d 开头的文件夹,大小竟然都是 4096。
用惯了 Windows,乍一看,这明显不合理,文件夹里那么多东西,为什么会只占用了 4KB?
要理解这个问题,就必须深入到 Linux 文件系统的底层设计。
一、Linux 中的目录不是容器,而是索引表
很多 Windows 用户对文件系统的理解是,文件放在文件夹里,文件夹越大,占用空间越多。
但在 Linux 中,这种理解是错的。
更准确的说法是,目录并不是存储文件内容的容器,而是一张“文件名到 inode 的映射表”。
举个简单例子,一个目录里可能记录的是这样的内容:
a.txt → inode 1001
b.log → inode 1002
c.jpg → inode 1003
目录本身只负责记名字和指路,真正的数据根本不在这里。
二、inode + block:Linux 的核心设计
Linux 文件系统之所以高效,是因为采用了经典的两层结构:
1. inode(索引节点)
inode 可以理解为文件的身份证,里面记录:
- 文件大小
- 权限(rwx)
- 所有者
- 时间信息
- 数据块位置(最关键)
但有一点非常重要:inode 不存储文件名。
2. block(数据块)
block 才是文件真正存储内容的地方,比如:
- 文本内容
- 图片数据
- 可执行程序
3. 文件名在哪里?
答案是:在目录里。
也就是说:文件名 → inode → block(数据)
这三者是分开的。
三、为什么目录大小是 4096?
现在可以回到最初的问题。
在大多数 Linux 文件系统中:一个磁盘块(block)默认大小是 4KB,也就是 4096 字节。
而目录本质上也是一个文件,它需要占用至少一个 block 来存储内容。
即使是一个空目录,里面也至少包含:
.   (当前目录)
..  (上级目录)
所以目录最小占用 = 1 个 block = 4096 字节
这就是为什么你看到的目录大小总是 4096。
四、什么时候会超过 4096?
虽然常见是 4096,但这个数字并不是固定不变。
当目录里的文件数量很多时,一个 block 放不下所有映射关系,就会扩展为多个 block:
8192
12288
16384
也就是说目录大小是 4096 的倍数,而不是固定值。
五、为什么这样设计?
这种 inode + block 的设计,是为了性能和灵活性。
1. 查找速度极快
打开一个文件的过程:
① 找目录
② 查文件名
③ 定位 inode
④ 读取数据块
整个过程是索引跳转,而不是全盘扫描。
2. 支持硬链接
由于文件名和数据分离,可以做到:
a.txt → inode 1001
b.txt → inode 1001
两个文件名指向同一份数据。
优点是:
- 不占额外空间
- 删除一个不影响另一个
3. 删除文件几乎瞬间完成
执行:
rm bigfile.log实际上只是:
- 从目录中删除文件名
- inode 引用计数减 1
如果引用为 0,才释放数据块。
所以删除一个 100GB 文件,几乎是瞬间完成的。
4. 空间利用更灵活
文件的数据块可以分散存储,不需要连续空间,这在机械硬盘时代尤为重要:
- 减少碎片问题
- 提高写入效率
六、如何查看真实目录大小?
ls -l 看到的是目录本身的大小。
如果想看目录里所有文件占用的空间,需要用:
du -sh backup输出才是实际使用的磁盘容量。
Linux 文件系统不是像 Windows 那样,文件装在文件夹里,而是:
目录:文件名索引表inode:文件元数据block:真实数据
理解这一点之后,很多看似诡异的现象都会变得合理:
- 为什么目录大小总是 4096
- 为什么删除大文件很快
- 为什么磁盘空间有时不会立刻释放
Linux 的文件系统设计,更像是一个高性能数据库,而不是简单的文件收纳盒。也正是这种设计,让它在高并发、高负载的服务器环境中依然稳定高效运行。
扩展阅读: