公众号旧文
vibe coding 哪家强?布里奇本奇最在行!
这两年,AI 的发展速度,已经快到让人有点儿跟不上节奏的程度。
于是,一个很现实的问题摆在面前:我到底该用哪个?
很多人第一反应肯定是自己一个一个试。
同样一个需求,分别丢给不同AI,但真正做起来,很快就会发现这件事几乎没有尽头。
模型不仅多,而且更新频率极高。你今天测出来的结论,可能三天之后就已经过时了。不同提示词、不同场景,还会让结果产生偏差。到最后,你消耗的大量时间,并没有换来一个长期有效的答案。
更麻烦的是,还有一个很多人一开始没意识到的问题:
AI,并不一定越更新越强。
不少用户在使用ChatGPT的过程中,就明显感受到这一点。
比如围绕GPT-4o,就曾出现新版本上线后,反而有人开始怀念旧版本。
说明用户并不是一味追新,而是在不断寻找一个最顺手的版本。
在传统软件世界里,也早就发生过类似的故事。比如当年的 Win 8,微软试图大幅推进触控化设计,结果却让大量桌面用户无所适从,熟悉的开始菜单消失,操作逻辑改变,学习成本陡然提高。即便后续推出 8.1 进行修补,整体口碑也难以扭转,很多用户直接选择跳过这一代系统。
这背后说明的是同一件事:
更新并不等于进步,有时候只是方向的改变。
把这个逻辑放回到 AI 身上,就更明显了。每一次模型升级,本质上都是一次取舍:是更快还是更准,是更开放还是更安全,是更擅长写代码还是更擅长聊天。而这些取舍,不可能对所有用户都是最优解。
于是问题就变得更复杂了,你不仅要比较不同模型,还要比较不同版本、不同时间点、不同任务下的表现。这件事如果完全靠个人去完成,成本高得几乎不现实。
也正是在这样的背景下,像 BridgeBench 这样的 AI 评测排行榜,开始变得有价值。
具体来说,它会把你平时使用 AI 的典型场景,拆分成一系列统一测试,比如代码生成能力、Bug 修复能力、响应速度、安全性、幻觉率,甚至包括生成网页界面的创意能力。然后用同一套题目、同一套规则,让不同模型来做题,最终形成清晰的排行榜。
这样一来,你不需要再亲自一个个测试模型,只需要看榜单,就能快速了解在当前这个时间点,谁更强,谁更稳,谁更适合你。
下面是4月12日,各 AI 幻觉测试的结果。
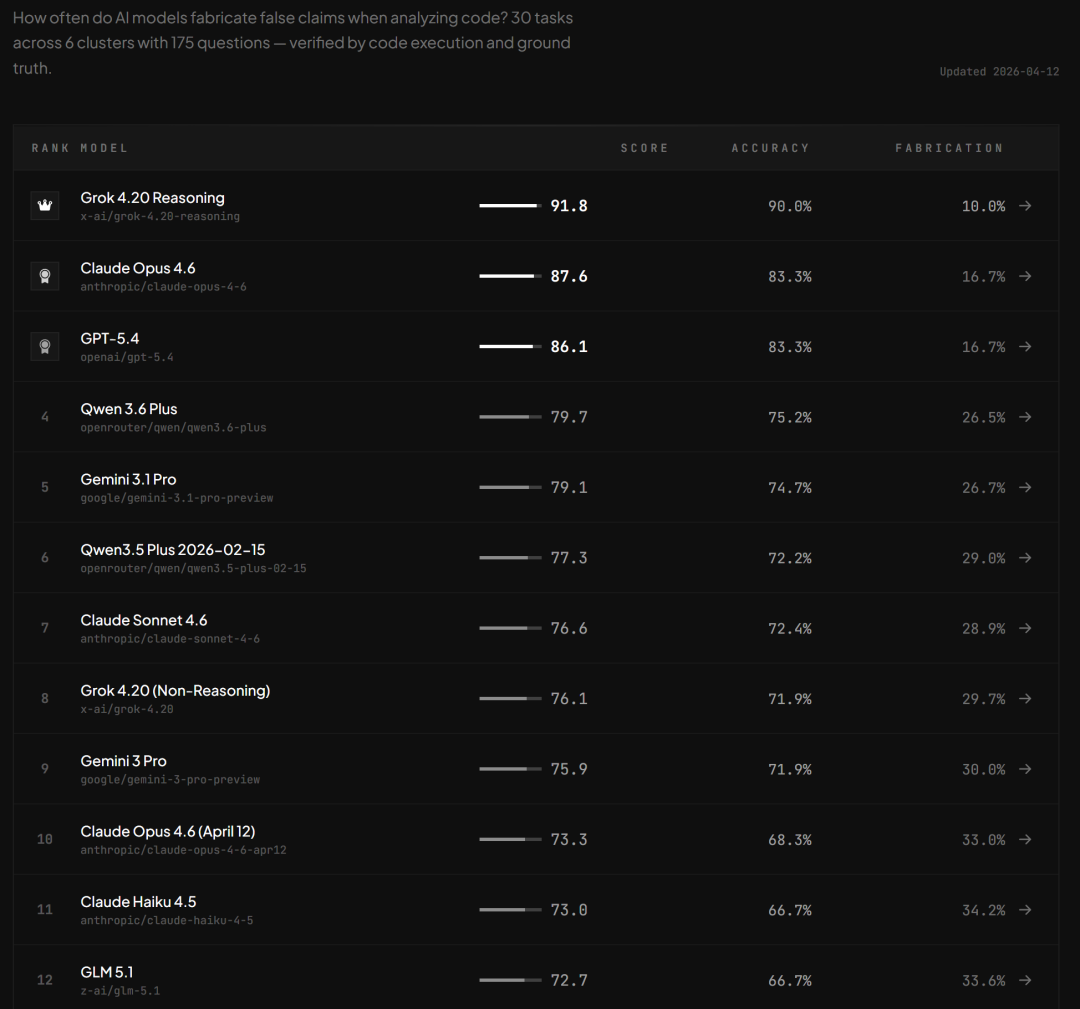
像 BridgeBench 这样的评测平台,在不断测试、不断更新、不断给出相对客观的结论。而你需要做的,只是基于这些结果,做一次更高效的选择。
当然,排行榜也不是绝对答案。不同人有不同需求,有人看重速度,有人看重质量,有人关注成本。所以更合理的方式,是把排行榜当作第一轮筛选工具,再结合少量实际体验,找到最适合自己的模型。
你可以选择自己反复试错,把时间花在比较工具上;也可以借助排行榜,把精力集中在真正重要的事情上。
在一个连升级都可能带来退步的时代,盲目追新,往往意味着更高的试错成本。而更聪明的做法,是让数据先帮你筛选,让结果为你指路。
所以,与其反复纠结哪家 AI 更强,不如直接看榜单。